Uma empresa recebe muitas mensagens de suporte. Algumas precisam apenas ser encaminhadas para a equipe certa; outras exigem uma resposta cuidadosa. Será que faz sentido usar o mesmo modelo para tudo? Uma ideia é usar uma ferramenta de decisões estruturadas para a triagem e chamar um modelo de linguagem quando for necessário escrever ou explicar algo.
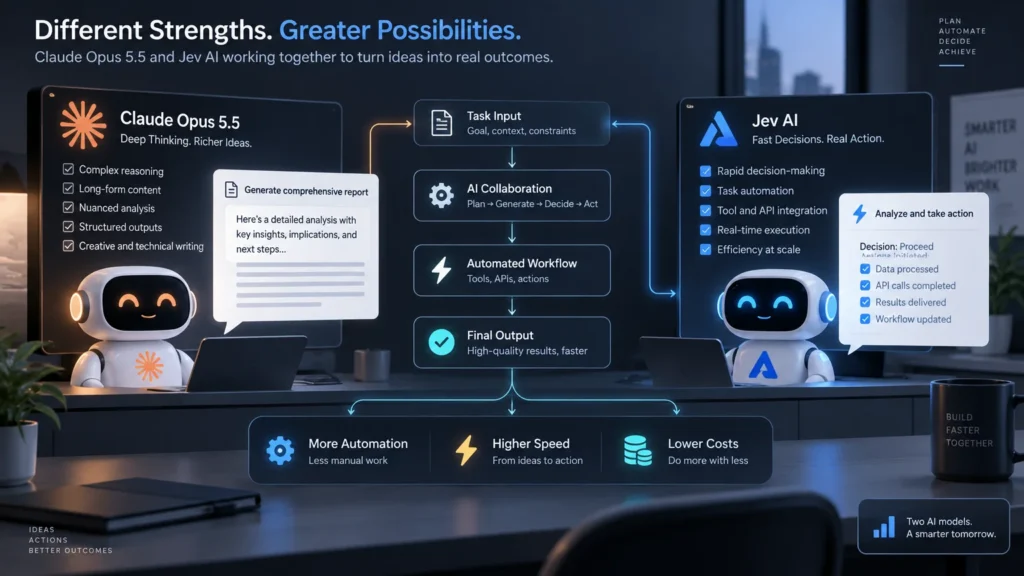
É nesse tipo de fluxo que Jev, da TypeSafe AI, pode ser considerado junto de um modelo como Claude Opus 5.5. Mas uma combinação dessas não garante economia ou mais rapidez por si só. O resultado depende da tarefa, do volume, dos custos de cada chamada e da precisão exigida.
O que cada ferramenta faz?
Claude Opus 5.5 é um modelo de linguagem que pode gerar texto, analisar informações e apoiar tarefas complexas. A Anthropic informa que ele custa menos por token que Opus 5 e gera respostas mais de 30% mais rápido que seu antecessor em testes da empresa. Esses números comparam versões de Opus; não medem uma integração com Jev.
Jev é apresentado pela TypeSafe AI como um modelo de decisões estruturadas. Em vez de escrever uma resposta aberta, ele recebe um contexto e perguntas com opções ou formatos definidos e devolve uma escolha, uma pontuação ou uma probabilidade. Isso pode ser útil para classificar uma mensagem ou decidir qual etapa de um fluxo deve ocorrer. Uma saída no formato esperado, porém, ainda pode conter uma decisão errada.
Como poderia funcionar a triagem de atendimento?
Imagine que a equipe queira organizar mensagens em três filas: cobrança, suporte técnico e vendas. Jev poderia receber a mensagem e retornar uma categoria predefinida. O sistema então encaminharia o pedido para a fila correspondente. Se a pessoa precisar de uma resposta elaborada, outro modelo, como Claude, poderia ajudar a preparar um rascunho para revisão.
Esse é um exemplo de arquitetura possível, não um resultado comprovado do vídeo que inspirou o tema. O vídeo apresenta uma experiência específica; não há aqui uma comparação independente que confirme a velocidade, a economia ou a precisão do fluxo mostrado.
Quando dividir a tarefa pode ajudar?
Uma etapa de decisão separada pode fazer sentido quando há muitas entradas parecidas, poucas categorias claras e um próximo passo simples para cada resultado. Pense em ordenar chamados por assunto ou selecionar qual documento precisa de uma revisão humana. Se a solicitação exige contexto amplo, empatia, explicação ou criação de texto, um modelo generativo pode ser mais adequado.
Na prática, dividir uma tarefa também acrescenta complexidade: mais uma integração para manter, mais um fornecedor, novas regras de privacidade e a possibilidade de um erro na primeira etapa encaminhar o pedido para o lugar errado.
Como testar antes de adotar
- Monte uma amostra representativa. Separe mensagens que cubram casos comuns, exceções e pedidos ambíguos. Retire dados pessoais ou use exemplos fictícios.
- Defina a resposta correta antes do teste. Combine quais rótulos são válidos e quando o sistema deve pedir ajuda humana.
- Compare os fluxos com as mesmas entradas. Teste a decisão estruturada, o modelo de linguagem e a combinação. Não compare números promocionais de tarefas diferentes.
- Meça o processo inteiro. Inclua chamadas repetidas, revisão humana, encaminhamentos incorretos, tempo total e custo do modelo usado para escrever.
- Crie uma faixa de segurança. Quando a confiança for baixa, quando as opções não cobrirem o caso ou quando o assunto tiver impacto relevante, envie para revisão em vez de agir automaticamente.
Uma métrica de confiança não garante que o sistema esteja correto. Ela pode ajudar a decidir quando pedir revisão, desde que você a avalie com exemplos reais e não a trate como certeza.
Cuidados com dados e ações automáticas
Antes de conectar um modelo ao atendimento, confira quais informações serão enviadas e as condições de retenção do fornecedor. Envie apenas o necessário e limite as permissões do sistema. Para começar, use a classificação apenas como sugestão para a equipe. Deixe ações como responder ao cliente, alterar uma cobrança ou encerrar um chamado sujeitas à aprovação humana.
Se a triagem falhar, você precisa conseguir encontrar o erro, corrigir a regra e recuperar a mensagem. Registros de decisão, uma fila de exceções e um caminho manual ajudam a manter o serviço funcionando.
O que o teste pode revelar
Talvez Jev reduza o custo de classificação em um volume alto de mensagens; talvez o modelo generativo já resolva a tarefa com qualidade suficiente; talvez a combinação economize chamadas, mas exija tanta revisão que não compense. Só uma avaliação no seu próprio fluxo pode responder a isso.
Comece com uma tarefa delimitada e compare os resultados com o processo atual. Se houver ganho claro sem piora de qualidade ou segurança, amplie devagar. Se a economia aparecer apenas em um benchmark do fornecedor, mas não na sua operação, ainda não há motivo para mudar o sistema.
Fontes e limites
- Anthropic — Claude Opus 5.5. Disponibilidade, preço e comparações divulgadas pelo próprio fornecedor.
- TypeSafe AI — Jev. Descrição do modelo e resultados de benchmark apresentados pela empresa; esses resultados se referem aos testes e fluxos descritos pelo fornecedor.
- Vídeo de referência no YouTube. Usado para definir o tema; os números e resultados apresentados nele não foram tratados como validação independente.